AI Systems Performance Engineering (3)
Introduction
Chris Fregly의 AI Systems Performance Engineering $_[$$_{1}$$_]$ Chapter 4는 GPU와 GPU, node와 node 사이에서 data를 옮기는 통신 계층을 다룬다.
vLLM으로 multi-node serving 환경을 구성하면서 NCCL_SOCKET_IFNAME과 GLOO_SOCKET_IFNAME을 맞추고 NCCL_DEBUG=TRACE로 all-reduce 결과를 하나씩 확인했던 적이 있고 (vLLM Discussion #11353), 그 뒤에 NCCL과 RDMA, RoCE를 정리한 글도 썼다.
이 장은 같은 주제를 성능 관점에서 다시 다루는데, 통신과 연산을 overlap하는 방법부터 NCCL 환경 변수의 함정, 그리고 추론용 point-to-point library인 NIXL까지 이어진다.
이번 글에서는 Chapter 4 (Tuning Distributed Networking Communication)를 다룬다.
Chapter 4: Tuning Distributed Networking Communication
규모가 커지면 가장 빠른 GPU도 memory와 disk, network 사이의 비효율적인 통신과 data 전송에 발목이 잡힌다.
이 장은 NVIDIA의 I/O 가속 platform인 Magnum IO $_[$$_{2}$$_,$$_{3}$$_]$에서 학습에 쓰이는 NCCL (NVIDIA collective communication library) $_[$$_{4}$$_,$$_{5}$$_]$과 GPUDirect RDMA (remote direct memory access) $_[$$_{6}$$_]$, GDS (GPUDirect Storage) $_[$$_{7}$$_]$, 그리고 disaggregated 추론을 위한 NIXL (NVIDIA inference xfer library) $_[$$_{8}$$_]$을 NVL72 $_[$$_{9}$$_]$ 같은 최신 GPU cluster 맥락에서 다룬다.
PyTorch $_[$$_{10}$$_]$ 같은 고수준 framework도 결국 이 저수준 library들 위에서 연산과 통신을 overlap하는데, 저자는 이 overlap을 책 전체에서 반복해서 등장하는 pattern으로 꼽는다.
목표는 multi-node, multi-GPU system의 모든 층에서 통신 지연과 CPU overhead를 줄여 GPU 활용률과 goodput을 높게 유지하는 것이다.
이 장에서 계속 나오는 collective는 GPU들이 buffer를 어떻게 주고받느냐로 나뉘는데, GPU 4장을 기준으로 전후 buffer를 비교하면 아래와 같고, 왼쪽 열은 root rank가 보내거나 받는 연산이고 오른쪽 열은 같은 행의 연산을 모든 rank로 확장한 연산이다 $_[$$_{11}$$_]$.
| 연산 | 동작 | 결과를 받는 rank | 대표적인 쓰임 |
|---|---|---|---|
| Reduce | 모든 rank의 buffer를 합산 같은 reduction으로 합침 | Root | Loss나 평가 지표를 rank 0으로 모아 logging |
| All-reduce | Reduce와 같지만 결과를 모든 rank가 받음 reduce 뒤 broadcast, 또는 reduce-scatter 뒤 all-gather와 같음 |
모든 rank (같은 결과) | DDP의 gradient 합산 $_[$$_{12}$$_]$ |
| Gather | 각 rank의 chunk를 rank 순서대로 모음 | Root | 각 rank의 추론·평가 결과를 rank 0으로 수집 |
| All-gather | Gather와 같지만 모은 결과를 모든 rank가 받음 | 모든 rank (같은 결과) | FSDP가 forward·backward 전에 sharding된 parameter를 복원 $_[$$_{13}$$_]$ |
| Scatter | Root의 buffer를 rank 수만큼 chunk로 나눠 하나씩 보냄 | 모든 rank (서로 다른 chunk) | Rank 0이 읽은 입력을 rank마다 나눠줌 |
| Reduce-scatter | Reduction 결과를 rank마다 chunk 하나씩 나눠 가짐 | 모든 rank (서로 다른 chunk) | FSDP가 gradient를 rank마다 나눠 가짐 $_[$$_{13}$$_]$ |
| Broadcast | Root의 buffer 전체를 모든 rank로 복사 | 모든 rank (같은 data) | DDP 초기화 때 rank 0의 model state를 모든 process로 보냄 $_[$$_{12}$$_]$ |
| All-to-all | Rank $i$의 $j$번째 chunk를 rank $j$로 보내 buffer를 전치 | 모든 rank (서로 다른 chunk) | MoE expert parallelism의 token dispatch와 combine $_[$$_{14}$$_]$ |
All-reduce가 reduce-scatter와 all-gather를 이어 붙인 것과 같다는 관계 덕분에 뒤에 나올 ring all-reduce가 정확히 이 두 단계로 동작한다.
Overlapping Communication and Computation (Pipelining)
Pipelining이라고도 부르는 통신과 연산의 overlap은 대규모 학습·추론 system에서 GPU가 data를 기다리는 시간을 줄이는 기법이다.
한 작업이 끝났을 때 다음 단계에 필요한 결과가 이미 전송 중이거나 도착해 있도록 data 전송을 진행 중인 연산과 동시에 실행하는 것이 핵심이고, PyTorch $_[$$_{10}$$_]$는 gradient all-reduce 같은 collective 통신을 연산과 나란히 실행하는 비동기 연산을 지원한다.
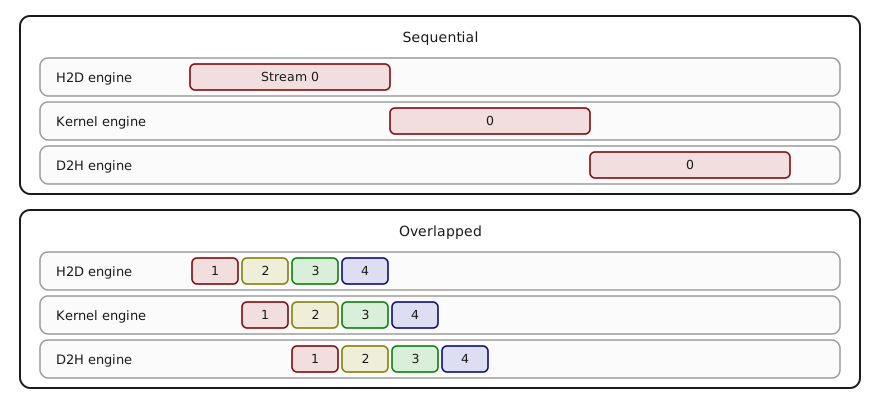
위는 H2D (host-to-device) 복사와 kernel 실행, D2H (device-to-host) 복사를 stream 하나로 차례대로 처리할 때와, 작업을 네 개의 CUDA stream으로 나눠 overlap할 때를 비교한 것이다.
복사는 GPU의 copy engine (DMA engine)이, kernel은 SM이 처리하는 별개의 hardware라서 복사 방향마다 copy engine이 따로 있는 GPU라면 H2D 복사와 kernel, D2H 복사를 동시에 실행할 수 있다 $_[$$_{15}$$_]$.
CUDA 기반 library도 같은 방식으로 여러 stream을 쓰는데, 한 stream이 무거운 행렬 곱을 실행하는 동안 다른 stream이 gradient 집계 같은 통신을 맡아 각 layer의 출력이 연산이 끝나자마자 집계나 다음 처리로 넘어간다.
Overlap을 돕는 기법으로는 batch를 키우거나 gradient accumulation으로 여러 minibatch의 update를 한 번의 동기화로 묶어 통신 횟수를 줄이는 것과, gradient compression으로 전송량 자체를 줄이는 것, 큰 tensor를 bucket 단위로 쪼개 준비된 부분부터 먼저 보내는 것이 있다.
Compression은 overlap을 직접 만들지는 않지만 network를 점유하는 구간을 짧게 해 연산이 방해받는 시간을 줄인다.
실제로 overlap되고 있는지는 PyTorch profiler $_[$$_{16}$$_]$나 NVIDIA Nsight Systems $_[$$_{17}$$_]$로 확인하면서 bucket 크기 같은 parameter를 조정한다.
큰 batch와 gradient accumulation, 비동기 전송, compression, bucketing을 하나의 전략으로 묶으면 대규모 distributed AI model도 network 한계를 넘어 유휴 시간을 줄일 수 있는데, 저자는 이 설계가 동기화 횟수를 최소화하면서 높은 처리량과 최적의 GPU 활용률을 함께 얻는 방식이라고 정리한다.
그 결과 학습과 추론 시간이 줄고 hardware를 더 효율적으로 쓰게 되며, engineer는 저수준 networking routine을 다시 만드는 대신 model 구조와 상위 parameter 조정에 집중할 수 있다.
Asynchronous Execution with Streams
Overlap은 결국 비동기 실행 위에서 성립하는데, GPU는 서로 다른 자원을 쓰는 여러 stream (연산 queue)을 동시에 실행할 수 있어서 한 stream이 행렬 곱 kernel을 실행하는 동안 다른 stream이 data 복사와 all-reduce를 처리하고, NCCL 같은 통신 library가 즉시 제어를 돌려주는 nonblocking 호출을 제공하는 덕분에 default stream은 독립적인 data에 대한 연산을 계속한다.
CUDA stream은 context마다 하나씩 있는 default stream과 사용자가 따로 만드는 non-default stream으로 나뉘는데, 같은 stream 안의 작업은 항상 순서대로 실행되고 overlap될 수 있는 것은 서로 다른 stream 사이의 작업뿐이다 $_[$$_{18}$$_]$.
| 항목 | Default stream | Non-default stream |
|---|---|---|
| 생성 | CUDA context마다 하나 (stream 0, NULL stream) | cudaStreamCreate()나 PyTorch torch.cuda.Stream()으로 생성 |
| 사용 시점 | Stream을 지정하지 않은 kernel launch와 cudaMemcpy |
Stream을 명시해 launch하거나 with torch.cuda.stream(s): 안에서 실행한 작업 |
| 다른 stream과의 관계 | Legacy default stream은 non-blocking stream을 제외한 모든 stream과 암묵적으로 동기화 | 서로 순서 보장이 없어 동시에 실행될 수 있음 |
주의할 점은 기본 설정의 legacy default stream이 같은 context의 다른 blocking stream과 암묵적으로 동기화한다는 것으로 $_[$$_{19}$$_]$, default stream의 작업은 다른 stream의 앞선 작업이 끝나야 시작하고 다른 stream의 뒤 작업도 이것이 끝날 때까지 기다리므로 서로 overlap되지 못한다.
이를 피하려면 cudaStreamNonBlocking flag로 stream을 만들거나, nvcc --default-stream per-thread로 thread마다 일반 stream처럼 동작하는 per-thread default stream을 쓴다.
실제로는 framework가 이 복잡함을 대부분 숨기는데, PyTorch DDP (DistributedDataParallel) $_[$$_{12}$$_]$는 backward pass에 hook을 걸어 gradient bucket이 준비될 때마다 전용 통신 stream에서 비동기 NCCL all-reduce를 띄우고, 그동안 default stream은 다음 layer의 gradient를 계속 계산한다.
PyTorch에서는 device마다 current stream이 있어 따로 지정하지 않으면 default stream이 쓰이고, DDP의 NCCL backend (ProcessGroupNCCL)는 collective용 stream을 따로 만들어 CUDA event로 필요한 지점에서만 서로를 기다리게 한다.
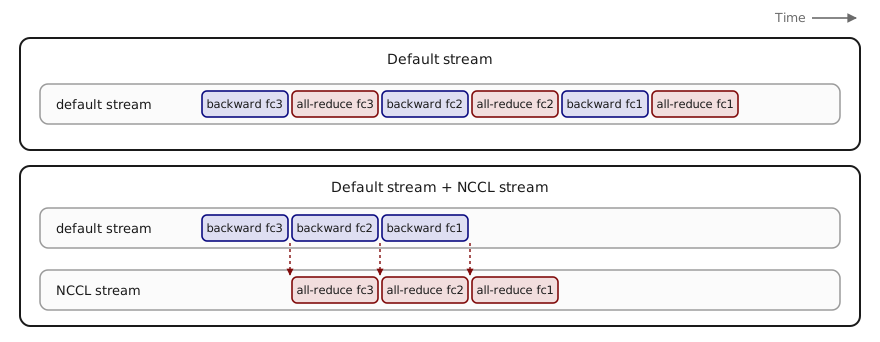
위처럼 default stream 하나에서는 backward와 all-reduce가 번갈아 직렬로 실행되지만, all-reduce를 NCCL stream으로 옮기면 fc3의 all-reduce가 fc2의 backward와 overlap되는 식으로 통신이 다음 layer의 연산 뒤에 가려진다.
이렇게 연산과 통신이 계단식으로 이어지는 pipeline을 유지하려면 torch.cuda.synchronize()나 torch.Tensor.item()처럼 device 전체 동기화를 일으키는 호출을 피해야 하고, iteration 시간을 재야 한다면 iteration 맨 끝에 동기화를 한 번만 둔다.
Reducing Communication Frequency and Volume
통신 한 번당 더 많은 일을 하게 만드는 대표적인 방법이 gradient accumulation이다.
Minibatch마다 all-reduce하는 대신 몇 개의 minibatch에 걸쳐 gradient를 local에서 누적한 뒤 한 번만 all-reduce하는 방식으로, minibatch 네 개를 누적하면 all-reduce 빈도가 1/4로 줄어드는 대신 누적된 gradient를 담을 memory가 더 들고 실질 batch size가 커져 수렴과 memory 사용량에 영향을 준다.
전송량을 줄이는 쪽으로는 gradient compression이나 quantization이 있고, 극단적으로는 gradient의 일부만 보내는 sparsification까지 가는데, 이 경우 정확도를 지키려면 algorithm 수준의 변경이 필요하다.
PyTorch DDP의 bucketing은 작은 tensor 여러 개를 큰 message로 묶어 호출당 overhead를 줄이지만 크기에 trade-off가 있다.
Bucket이 너무 크면 대역폭은 잘 쓰지만 gradient가 충분히 쌓일 때까지 all-reduce 시작이 늦어지고, 너무 작으면 일찍 보내는 대신 작은 NCCL 호출이 많아져 overhead가 커진다.
기본값 25 MB는 대부분의 경우 overlap이 잘 되는 균형점인데, layer가 아주 큰 model이라면 키우고 작은 layer가 많은 model이라면 줄여서 통신을 일찍 시작하는 편이 나을 수 있어 결국 여러 크기를 profiling해 보는 수밖에 없다.
Achieving Maximal Overlap in Practice
책은 GPU 두 장으로 같은 학습 step을 두 번 구현해 비교하는데, 첫 번째는 DDP의 hook을 쓰지 않고 loss.backward()가 모두 끝난 뒤 parameter마다 직접 all-reduce하는, overlap이 전혀 없는 구현이다.
1 | # Synchronous gradient all-reduce after backward |
Forward와 backward에 10 ms, all-reduce에 12 ms가 걸린다면 이 방식의 iteration은 둘을 더한 22 ms이고, 완전히 overlap되는 구현이라면 둘 중 큰 값인 12 ms에 가까워진다.
Nsight Systems로 보면 fc1, fc2, fc3의 backward kernel이 모두 끝난 다음 NCCL all-reduce kernel이 나타나고, 통신 구간 동안 GPU는 NCCL 작업 외에는 idle 상태로 남는다.
두 번째는 model을 DistributedDataParallel로 감싸 동기화를 DDP에 맡기는 구현이다.
1 | ddp_model = nn.parallel.DistributedDataParallel(model, device_ids=[rank]) |
loss.backward()가 호출되면 DDP의 reducer가 gradient를 bucket으로 나누고, bucket이 준비되는 대로 별도 CUDA stream에서 NCCL all-reduce를 띄운다.
Backward에서 가장 먼저 계산되는 마지막 layer (fc3)의 gradient부터 바로 all-reduce되기 시작해 backward가 끝날 무렵에는 앞쪽 layer의 all-reduce도 대부분 끝나 있고, profiler timeline에는 backward kernel과 NCCL all-reduce kernel이 번갈아 나타난다.
다만 model이 너무 작아 gradient 전체가 bucket 하나에 들어가면 마지막에 all-reduce가 한 번만 일어나 거의 overlap되지 않는다.
| 지표 | No overlap (manual sync) | Overlap (DDP) | 비고 |
|---|---|---|---|
| Backward + 통신 총 시간 | 100% (baseline) | baseline의 ~70% | Overlap 덕분에 iteration당 약 30% 단축 (예시) |
| 통신 시작 시점 | Backward 완료 후 | Backward 도중 | DDP에서는 backward 중간에 통신이 시작 |
| 통신 구간의 GPU 유휴 | 있음 backward 후 all-reduce 동안 대기 |
최소 다른 layer 연산 중에 통신 |
DDP가 지연 대부분을 숨김 |
| SM 활용률 | 낮음 통신 중 SM이 idle인 cycle 발생 |
높음 연속적으로 활동 |
Overlap이 GPU를 꾸준히 바쁘게 유지 |
| Overlap 비율 (연산에 가려진 통신) | 0% (직렬 실행) | ~50% 이상 | 큰 model이나 batch일수록 overlap이 커짐 |
표의 수치는 개념 설명을 위한 예시이고, 실제 benchmark 결과는 책의 GitHub 저장소 $_[$$_{1}$$_]$에 따로 있다.
이 예시에서는 overlap으로 iteration 시간이 약 30% 줄었는데, model이 클수록 통신 병목이 생길 여지가 커서 이득도 더 커진다.
PyTorch DDP는 기본으로 25 MiB bucket을 쓰고, bucket_cap_mb를 조정하면 model 구조에 맞춰 overlap을 늘릴 수 있지만 bucket이 커질수록 마지막 bucket의 지연이 길어진다.
잘 조정된 DDP라면 gradient 통신 대부분이 연산에 가려지고, 마지막 연산보다 늦게 끝나는 마지막 bucket 정도만 드러난다.
Gradient가 먼저 확정된 parameter부터 optimizer step을 시작해 통신과 overlap하자는 제안 $_[$$_{20}$$_]$이나 tensor를 분할해 overlap을 더 늘리려는 연구도 진행 중이지만, DDP의 기본 전략은 gradient를 bucket으로 묶고 준비되는 즉시 reduction을 시작하는 WFBP (wait-free backpropagation)로 설명된다.
반대로 backward와 다음 iteration 사이에 동기화를 강제하는 code 한 줄이 overlap을 통째로 없앨 수 있다.
Debugging용으로 넣은 print()나 log에서 tensor에 .item()을 호출하면 GPU에서 CPU로의 이동이 동기화를 강제해 연산이 멈추므로, 이런 작업은 가능하면 별도 stream으로 옮기고 torch.cuda.synchronize()는 정확한 benchmark나 정합성이 필요한 경우에만 쓴다.
NVIDIA Magnum IO Optimization Stack
Magnum IO $_[$$_{2}$$_,$$_{3}$$_]$는 GPU와 CPU, storage, network interface 사이의 data 이동과 접근, 관리를 가속하는 NVIDIA의 I/O platform으로, storage와 network, in-network computing, I/O 관리의 네 구성 요소로 나뉜다.
| 구성 요소 | 대표 기술 | 역할 |
|---|---|---|
| Storage I/O | GDS $_[$$_{7}$$_]$, BlueField SNAP $_[$$_{21}$$_]$ | GPU가 host CPU memory를 거치지 않고 NVMe SSD 같은 storage에 직접 접근 (Chapter 5) |
| Network I/O | GPUDirect RDMA $_[$$_{6}$$_]$, NCCL $_[$$_{4}$$_,$$_{5}$$_]$, NVSHMEM $_[$$_{22}$$_,$$_{23}$$_]$, UCX $_[$$_{24}$$_,$$_{25}$$_]$, HPC-X $_[$$_{26}$$_]$ | Node 사이 GPU 통신에서 CPU를 우회하는 고속 직접 전송 |
| In-network compute | SHARP $_[$$_{27}$$_]$, BlueField DPU $_[$$_{28}$$_]$ | Quantum 계열 InfiniBand switch silicon 안에서 reduction 연산을 수행 |
| I/O management | NetQ $_[$$_{29}$$_]$, UFM $_[$$_{30}$$_]$ | I/O fabric의 실시간 telemetry와 진단, 생명주기 관리 |
Network I/O의 UCX (unified communication X)는 여러 interconnect를 하나의 API로 감싸는 HPC library이고, HPC-X는 MPI와 SHMEM을 묶은 software bundle이다.
In-network compute의 SHARP (scalable hierarchical aggregation and reduction protocol)는 1편에서 NVSwitch와 InfiniBand switch 양쪽의 in-network reduction으로 다룬 기술이다.
BlueField DPU (data processing unit)가 networking을 offload하면서 Subnet Manager와 SHARP Aggregation Manager 같은 제어 service를 올릴 수 있고, NCCL RDMA SHARP plugin $_[$$_{31}$$_]$이 켜져 있고 fabric에 SHARP firmware와 Aggregation Manager가 떠 있으면 조건에 맞는 collective가 InfiniBand switch로 offload된다.
Ethernet 기반 GPU cluster는 RoCEv2로 RDMA를 쓰지만 SHARP 같은 기능이 대체로 없어서, 초대형 AI system이 Ethernet 대신 InfiniBand를 고르는 이유 중 하나가 된다.
Magnum IO는 hardware와 함께 계속 발전하고 있어 이제 rack 안 GPU 통신을 fabric 규모로 넓히는 NVLink Switch domain을 지원하고, InfiniBand의 Quantum-2와 Quantum-X800 $_[$$_{32}$$_]$, Ethernet의 Spectrum-X $_[$$_{33}$$_]$로 통신 overhead를 더 줄인다.
High-Speed, Low-Overhead Data Transfers with RDMA
RDMA is a technology optimized for low-latency, high-throughput data transfers.
RDMA works by allowing direct memory-to-memory communication between devices without burdening the CPU with unnecessary data-copy operations.
RDMA는 전통적인 kernel network stack을 대부분 우회해 NIC가 application memory를 직접 읽고 쓰게 하므로, packet마다 CPU가 개입하지 않고 context switch와 buffer 복사도 줄어든다.
저자는 RDMA 경로를 쓸 수 있으면 우선 쓰되, log와 microbenchmark로 RDMA data path가 실제로 켜져 있는지를 계속 재확인하라고 강조한다.
Docker나 Kubernetes 같은 container 환경에서는 container가 host의 InfiniBand device (/dev/infiniband)에 직접 접근할 수 있어야 한다.
그렇지 않으면 NCCL이 아무 오류 없이 GPUDirect RDMA 대신 TCP socket으로 fallback해 처리량이 수십 GB/s에서 몇 Gb/s로 떨어지고, 일부 “rdma-shared” Docker image처럼 container의 GID 할당이 host와 맞지 않으면 GPUDirect 등록이 막혀 진짜 GPU 기반 RDMA 대신 CPU가 주도하는 RDMA 복사로 실행된다.
진짜 GPUDirect RDMA인지 확인하려면 lsmod | grep nvidia_peermem으로 kernel module이 올라왔는지, dmesg에 초기화 기록이 있는지 보고, NCCL을 NCCL_DEBUG=INFO로 실행해 NET/IB 경로를 확인한 뒤 perftest $_[$$_{34}$$_]$를 --use_cuda로 실행해 GPU 간 전송을 검증한다.
NVIDIA의 GPU용 RDMA 구현이 GPUDirect RDMA $_[$$_{6}$$_]$로, InfiniBand나 RoCE (RDMA over converged Ethernet) 같은 RDMA 지원 NIC가 서버 두 대 사이에서 host CPU와 system RAM을 완전히 건너뛰고 GPU device memory를 직접 DMA (direct memory access)하게 한다.
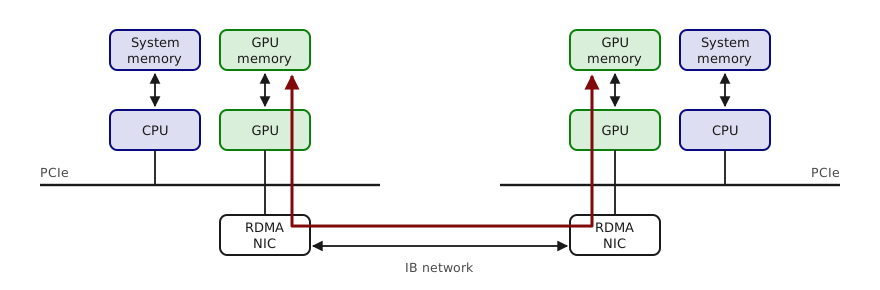
GPU buffer를 NIC에 등록해두면 원격 GPU 사이에서 one-sided RDMA read와 write가 가능해져 multi-node 학습의 지연과 CPU overhead가 함께 줄어든다.
RDMA는 InfiniBand에서는 기본으로 지원되고 Ethernet에서는 RoCE로 쓸 수 있는데, 이 경우 network 장비가 RDMA를 지원하고 올바르게 설정돼 있어야 하며 InfiniBand와 RoCE용 NVIDIA OFED (OpenFabrics enterprise distribution) $_[$$_{35}$$_]$ 같은 driver가 필요하다.
성능 차이도 커서, 최신 InfiniBand link는 작은 message의 지연이 수 µs 수준인데 Ethernet 위의 일반 TCP는 5~10배 높고, network 대역폭이 병목인 큰 전송에서는 InfiniBand RDMA가 수백 Gbps를 유지하는 반면 TCP/IP는 kernel overhead와 NIC 속도에 묶여 RDMA를 지원하는 200~400 Gbps Ethernet이 아니면 100 Gbps 이하에 머무는 경우가 많다.
Gradient처럼 message가 큰 분산 학습에서는 작은 message의 지연보다 큰 message의 처리량이 더 중요하다.
Ethernet밖에 없다면 가능한 한 높은 대역폭과 낮은 지연 구성을 써야 해서, 200 Gbps 이상의 RoCE가 10~25 Gbps TCP보다 all-reduce 트래픽에서 훨씬 낫고, 최소한 MTU (maximum transmission unit) 9000 같은 jumbo frame은 켜서 작은 packet 여러 개 대신 큰 packet을 적게 보내 CPU overhead를 줄여야 한다.
TCP stack도 같은 이유로 조정해야 하는데, net.core.rmem_max/wmem_max와 autotuning 범위인 net.ipv4.tcp_rmem/tcp_wmem이 고대역폭 link를 다 쓸 만큼 충분히 큰지 확인한다.
외부 인터넷 트래픽이 없는 전용 cluster network라면 기본 congestion control인 CUBIC으로 대체로 충분하고, 지연과 대역폭이 모두 큰 link라면 BBR (bottleneck bandwidth and round-trip propagation time) $_[$$_{36}$$_]$ 같은 최신 algorithm을 검토하며 sysctl net.ipv4.tcp_congestion_control로 현재 설정을 확인한다.
Cloud나 hybrid 환경이라면 정말로 통제된 고속 연결 위에 있는지부터 의심해야 한다.
AWS EC2의 EFA (elastic fabric adapter) $_[$$_{37}$$_]$는 같은 placement group 안의 instance 사이에서 InfiniBand에 가까운 RDMA를 주지만, 직접 연결 없이 on-premises data center와 cloud에 걸친 multi-node job은 공용 인터넷을 지나 지연과 혼잡을 예측할 수 없게 되므로 cloud provider와 함께 network의 모든 hop을 확인해야 한다.
RDMA를 쓰더라도 CPU가 완전히 빠지지는 않는데, host가 여전히 RDMA 전송을 설정하고 완료 event를 처리하기 때문이다.
그래서 network interrupt 처리나 polling thread를 NIC, 가능하면 GPU와도 같은 NUMA node의 core에 pin해야 하고, InfiniBand HCA (host channel adapter)가 NUMA node 0에 있다면 그 interrupt affinity도 node 0의 core로 묶는다 (2편의 NUMA pinning과 같은 원칙이다).
Tuning Multinode Connectivity
분산 multi-node 학습에서 network가 병목이 되지 않으려면 앞서 본 기술을 쓰는 것에 더해 제대로 설정해야 하는데, 저자는 다음 여섯 가지를 권한다.
- Understand the topology:
nvidia-smi topo -m으로 GPU interconnect를 기본적으로 파악하되, NVSwitch와 NVLink 기반 system이라면nvidia-smi nvlink나 Nsight Systems로 multi-hop switch fabric 연결까지 확인한다. - Leverage NVLink Switch domains if available: GB200과 GB300 NVL72 $_[$$_{9}$$_]$는 NVLink Switch로 GPU 72장을 한 NVLink domain에 묶어 hop당 수백 ns 수준의 지연과 rack 전체 ~130 TB/s의 all-to-all 대역폭을 준다. NVIDIA Quantum 계열 InfiniBand switch도 link당 800 Gb/s를 주지만 NVLink의 rack 내부 대역폭과 1 µs 미만의 지연에는 못 미치므로, job을 같은 NVLink domain 안에 배치해 traffic을 최대한 NVLink/NVSwitch에 둔다.
- Use RDMA whenever possible: InfiniBand나 RoCE hardware라면 NCCL이 실제로 RDMA를 쓰는지 확인한다. NCCL은 GPUDirect RDMA를 자동으로 쓰지만 설정이 틀리면 조용히 TCP로 fallback하는데, all-reduce 중에 GPU 활용률은 떨어지고 CPU 사용률이 치솟는다면 CPU가 통신용 data를 복사하고 있다는 신호다.
- Aggregate bandwidth with multiple NICs if available: NIC가 여러 개라면 NCCL이 traffic을 나눠 싣는 multirail로 대역폭을 합칠 수 있고, 이때
NCCL_NSOCKS_PERTHREAD와NCCL_SOCKET_NTHREADS를 조정해야 할 수 있다. NIC마다 subnet이 달라야 하고 NCCL이 모두 발견할 수 있어야 하며, 800 Gbps NIC 두 개를 병렬로 쓰면 1.6 Tbps, 네 개면 ~3.2 Tbps가 된다. - Utilize optimized “direct NIC” mode when available: GPU 하나 또는 작은 GPU group마다 충분한 전용 network 대역폭을 주는 multirail 구성을 우선한다. NIC는 물리적으로 PCIe를 통해 host CPU나 DPU에 붙는데, 최신 GPU system에서 NCCL은 IBGDA (InfiniBand GPUDirect Async) $_[$$_{38}$$_]$와 direct NIC 경로로 GPU가 CPU 개입 없이 full-bandwidth RDMA를 직접 구동하는 GPU-initiated networking을 지원한다.
- Check for misconfigurations: 흔한 함정은 network 설정 불일치로 느린 경로로 fallback하는 것이다. RDMA가 설정 오류로 안 되면 NCCL이 100 Gbps Ethernet 위의 TCP를 쓰면서 kernel overhead 때문에 그 일부만 쓰게 되고, 더 나쁘면 고속 network를 잘못 인식해 10 Gbps 관리용 network로 traffic이 흐르는데, NCCL debug 출력과
ibstat,ifstat같은 interface counter로 어느 interface가 주로 쓰이는지 확인한다.
Multinode Communication Pitfalls
Node를 여러 대로 넓히면 새로운 종류의 함정이 생기는데, 책은 여섯 가지를 예제와 함께 든다.
Pitfall #1: Using a CPU-bound Gloo backend instead of NCCL
PyTorch 분산 framework는 여러 통신 backend를 지원하는데, NVIDIA GPU에는 NCCL이 기본이고 CPU와 TCP socket을 쓰는 Gloo $_[$$_{39}$$_]$가 fallback으로 있다.
GPU 학습에서 실수로 Gloo로 ProcessGroup을 초기화하거나 NCCL 초기화가 실패해 Gloo로 넘어가면 학습은 정상적으로 실행되지만 모든 GPU 간 통신이 CPU와 Ethernet stack을 거쳐, crash 없이 한 자릿수 느린 채로 profiler나 log를 꼼꼼히 봐야만 드러난다.
책은 800 Gb/s (100 GB/s) InfiniBand로 연결된 두 “node”에서 400 MB tensor를 all-reduce하는 script를 backend="gloo"로 먼저 실행한다.
1 | Rank0: All-reduce of 400.0 MB took 200.00 ms (2 GB/s) |
2 GB/s는 hardware가 낼 수 있는 100 GB/s에 한참 못 미치고, 이때 CPU 사용률은 100%에 가깝다.backend="nccl"로 바꾸고 GPU 직접 통신이 가능하게 환경을 맞추면 결과가 두 자릿수 차이로 바뀐다.
1 | Rank0: All-reduce of 400.0 MB took 4.00 ms (100 GB/s) |
NCCL에서는 GPU가 다른 GPU의 memory에 직접 접근해 all-reduce를 수행하므로 SM이 network 복사 kernel을 실행하거나 GPU의 DMA engine이 일하는 반면, Gloo에서는 data가 CPU memory buffer와 TCP를 거치는 동안 GPU는 사실상 idle 상태다.
사용 중인 backend는 torch.distributed.get_backend() $_[$$_{40}$$_]$로 확인할 수 있고, NIC가 여러 개인 production 환경에서는 NCCL_SOCKET_IFNAME=ib0처럼 NCCL의 초기 TCP handshake가 InfiniBand HCA로 나가도록 명시해 bootstrap 후 가장 빠른 경로의 GPUDirect RDMA로 넘어가게 해야 한다.
Pitfall #2: Mismatched NCCL versions
PyTorch에 번들된 NCCL (torch.cuda.nccl.version())과 system에 설치된 libnccl의 version이 다르면 system이 hang되거나 더 나쁘게는 알아채기 어렵게 느린 구현으로 fallback한다.nvidia-nccl-cu* package를 맞추거나 system NCCL에 맞춰 PyTorch를 다시 build해 version을 일치시킨다.
Pitfall #3: TCP port exhaustion during NCCL bootstrap
NCCL은 out-of-band 초기 설정에 임시 TCP port를 쓰는데, OS의 net.ipv4.ip_local_port_range가 너무 좁으면 port가 바닥나 handshake가 실패하거나 멈춘다.
최신 NCCL은 bootstrap 처리가 개선됐지만, 큰 cluster라면 /proc/sys/net/ipv4/ip_local_port_range의 범위를 (예를 들어 50000 51000) 미리 넓혀두는 것이 좋다.
Pitfall #4: Insufficient network bandwidth or misconfigured NICs
동기화할 data 양에 비해 network 대역폭이 모자라거나 가용 interface를 다 쓰지 못하는 경우로, Blackwell GPU라면 node당 400 Gbps link 하나는 쉽게 포화되므로 cluster가 커질수록 흔해진다.
Node를 늘렸는데 GPU당 처리량이 떨어진다면 network link부터 확인하는데, nvidia-smi dmon으로 NVLink/PCIe/network 통계를 모으거나 ethtool -S <iface>, ip -s link show <iface>로 byte/packet counter를 보고, iftop이나 nload로 NIC 처리량을 실시간으로 볼 수 있다.
800 Gbps link를 포화시키는데 더 필요하다면 NCCL의 multi-NIC 지원을 켜고, NCCL이 network 전송에 쓰는 병렬 연결 수와 thread 수를 정하는 NCCL_NSOCKS_PERTHREAD와 NCCL_SOCKET_NTHREADS를 조정한다.
NIC가 두 개라면 NCCL_NSOCKS_PERTHREAD=2, NCCL_SOCKET_NTHREADS=2로 process당 연결 네 개를 만드는 식인데, NVIDIA 지침상 두 값의 곱은 64를 넘으면 안 되고 thread가 늘수록 CPU를 더 쓰므로 2, 4, 8처럼 단계적으로 올리며 처리량을 계속 잰다.
Pitfall #5: Straggler nodes or processes
동기화는 모든 node와 GPU의 응답을 기다리므로 multi-node 학습의 속도는 가장 느린 node가 정하고, network link가 느리거나 다른 작업으로 과부하된 machine 하나가 job 전체를 늦춘다.
가능하면 동일한 hardware와 전용 cluster 자원을 쓰고 (cloud에서 instance type이나 switch fabric을 섞으면 편차가 생긴다), node마다 DCGM $_[$$_{41}$$_,$$_{42}$$_]$이나 InfiniBand counter로 NIC link flapping이나 GPU thermal throttling을 감시한다.
특정 rank가 계속 뒤처지는지는 torch.distributed.monitored_barrier로 잡을 수 있다.
1 | try: |
30초 안에 도착하지 않는 rank에서 오류가 나므로 straggler를 특정할 수 있고, 여기에 NCCL_DEBUG=INFO와 NCCL_ASYNC_ERROR_HANDLING=1을 함께 켜면 어느 rank나 link가 느린지 PyTorch와 NCCL 양쪽 log로 볼 수 있다.
Pitfall #6: GPU memory fragmentation under UCX/RDMA
PyTorch의 caching allocator는 iteration을 넘어 GPU memory를 붙잡고 있는데, UCX/RDMA를 쓰는 분산 환경에서는 이렇게 오래 살아 있는 할당이 registration pool을 고갈시키거나 memory를 단편화해 산발적인 할당 실패나 급격한 성능 저하를 일으킨다.torch.cuda.memory_reserved()와 memory_allocated()를 비교하면 드러나는데, 책의 예제는 매 iteration 할당과 해제를 반복할 때 allocated는 0으로 돌아가도 reserved는 계속 늘어나 OS나 UCX registration pool로 돌아가지 않는 모습을 보여준다.
1 | [Iter 00] Reserved: 0.800 GB, Allocated: 0.800 GB |
최신 CUDA runtime으로 올리는 것이 우선이고, torch.cuda.empty_cache()는 단편화에서 빠져나오는 최후의 수단일 뿐 장기적으로는 allocator를 조정하고 원인을 찾아 고쳐야 한다.
정리하면 GPU 통신에는 항상 NCCL을 쓰고, RDMA와 고속 network가 실제로 켜져 있는지 확인하며, 여러 NIC를 포함해 가용 대역폭을 모두 쓰고, CUDA와 함께 나오는 최신 NCCL로 수정 사항을 받으면서 느린 통신으로 fallback시키는 설정이 없는지 살피는 것이다.
NCCL for Distributed Multi-GPU Communication
NVIDIA NCCL is a many-to-many communication library for operations, called collectives, used by groups of GPUs to share data.
NCCL underpins most multi-GPU training workloads in NVIDIA’s ecosystem.
NCCL $_[$$_{4}$$_,$$_{5}$$_]$은 all-reduce와 all-gather, broadcast, reduce-scatter 같은 collective를 GPU 몇 장부터 수천 장까지 확장되도록 최적화해 제공한다.
분산 학습에서는 각 GPU가 자기 data 조각으로 gradient를 계산한 뒤 NCCL로 모든 GPU의 gradient를 all-reduce해 평균 gradient로 weight를 update하고, 분산 추론에서는 activation 같은 중간 결과를 주고받는다.
추론에서는 일부 framework가 NCCL의 send()와 recv()를 쓰지만, 꼬리 지연과 overlap 때문에 UCX나 NIXL 같은 전용 library를 선호하는 배포가 많다.
NCCL은 PCIe와 NVLink, NVSwitch, InfiniBand, TCP socket을 모두 지원하면서 두 GPU 사이의 가장 빠른 경로를 자동으로 고른다.
이를 보완하는 것이 추론과 KV cache 이동 같은 point-to-point 전송에 맞춘 NIXL로, POSIX file과 GDS 같은 pluggable storage backend를 제공하고 Amazon S3 같은 object store는 plugin으로 지원해 KV cache 조각을 memory 계층과 storage 사이로 옮긴다.
Topology Awareness in NCCL
NCCL은 GPU가 물리적으로 어떻게 연결돼 있는지 감지해 통신 pattern을 최적화한다.
단순한 ring all-reduce로 모든 link를 균등하게 쓸 수도 있지만, 기본적으로는 topology를 인식하는 계층적 pattern을 자동으로 써서 NUMA domain이 여러 개인 system이라면 node 안 reduce, node 간 reduce, node 안 broadcast 순으로 실행되는 hierarchical all-reduce를 수행해 가장 빠른 interconnect에 traffic을 최대한 싣는다.
GPU 0과 1, 2와 3이 각각 NVLink로 묶여 있고 두 쌍 사이는 느린 PCIe로만 이어진 system이라면, NCCL은 NVLink로 이어진 쌍 안에서 먼저 reduce하고 각 쌍에서 GPU 하나씩만 PCIe로 교환한 뒤 쌍 안에서 다시 분배해 느린 PCIe link가 data의 일부만 나르게 한다.
GPU 네 장 전체를 ring 하나로 처리하는 naive한 방식이라면 PCIe switch 사이 link로 많은 data가 지나가 큰 병목이 된다.
선택지들의 성능이 비슷하거나 message가 작으면 자동 감지가 작동하지 않을 수도 있어서 NCCL_ALGO $_[$$_{43}$$_]$ (NVLS, NVLSTree, Tree, Ring, PAT 등)로 algorithm 선택을 덮어쓸 수 있지만, NCCL이 대체로 잘 고르므로 수동 지정은 문제 추적이나 연구 실험 정도에만 쓴다.
Topology에 맞춰 최적화됐는지는 Nsight Systems나 NCCL trace로 확인할 수 있는데, 계층적 algorithm이 쓰이면 group 안과 group 사이의 kernel이 여러 개로 나뉘어 보이고, topology를 무시한 algorithm은 all-reduce 한 단계가 PCIe를 지나느라 GPU당 수십 GB/s에 머무는 반면 topology를 인식한 algorithm은 NVLink를 다 써서 수백 GB/s를 낸다.
| 지표 | Before (no overlap) | After (with overlap) |
|---|---|---|
| SM busy | 60% | 90% |
| Memory stall warps | 많음 | 훨씬 적음 |
| Iteration time | 100 ms | 70 ms |
PCIe를 기다리는 naive한 방식에서는 많은 warp가 memory 접근에 묶여 SM 활용률이 60%에 머물고 iteration이 100 ms 걸리지만, topology를 인식하면 SM 활용률이 90%로 오르고 iteration이 70 ms로 30% 줄어든다.
경험칙은 통신을 가장 빠른 interconnect (node 안이라면 대개 NVLink/NVSwitch)에 최대한 두고 PCIe나 NUMA node 간 link 같은 느린 경로의 전송을 최소화하는 것이다.
GPU의 직접 NVLink lane 수는 정해져 있어서 GB200/GB300 NVL72의 Blackwell GPU는 link당 ~100 GB/s인 NVLink 5 link 18개로 양방향 합계 ~1.8 TB/s (이전 세대 900 GB/s의 두 배)를 갖는데, 직접 연결되지 않은 device 사이의 통신은 더 적은 lane이나 PCIe로 떨어지고 NUMA domain을 건너면 처리량이 크게 준다.
NVL72 rack에서는 72장의 Blackwell GPU가 모두 한 NVLink Switch domain에 속해 어떤 GPU든 NVSwitch 한 단계로 full bisection bandwidth에 도달하고, NVLS 지원과 함께 균일한 all-to-all 연결을 제공한다.
NCCL이 가장 대역폭이 큰 경로를 고르는지 profiling으로 확인했는데도 대역폭 한계에 부딪힌다면, 느린 link로 GPU 여덟 장에 걸치기보다 같은 NUMA node나 같은 NVSwitch island의 네 장처럼 촘촘하게 연결된 부분 집합으로 job을 좁히는 편이 낫고, 제한적이거나 간접적인 link의 동기화 overhead가 GPU를 더 쓰는 이득보다 큰 경우가 많다.
Grace Blackwell Superchip처럼 CPU와 GPU 사이를 900 GB/s NVLink-C2C로 잇는 superchip에서는 CPU memory가 GPU memory의 고속 확장처럼 동작해, all-reduce 일부가 CPU나 system memory를 거쳐도 이전 세대의 GPU 간 link만큼 빠를 수 있다.
NVLink 경로가 제대로 쓰이는지는 Nsight Systems나 NCCL_DEBUG=INFO, NCCL_TOPO_DUMP_FILE=<path>로 남긴 NCCL trace로 확인한다.
NCCL Communication Algorithms
NCCL은 data 크기와 GPU 수, topology에 따라 내부적으로 Ring과 Tree, CollTree, CollNet, PAT 같은 algorithm을 골라 쓴다.
| Algorithm | 구조 | 특징 |
|---|---|---|
| Ring | GPU를 논리적 ring으로 배치하고 이웃과 pipeline 방식으로 주고받으며 부분합을 ring을 따라 한 바퀴 순환시킴 | Link마다 2 × (data_size ÷ num_gpus) bytes로 부하가 균등한 bandwidth 최적 구조지만 GPU 수에 비례해 지연이 늘어 큰 message (bandwidth-dominated)에 적합 |
| Tree · NVLSTree | Spanning tree로 reduction과 broadcast를 수행 | O(log N) 단계로 지연이 낮아 작은 message (latency-dominated)에 적합하지만 leaf GPU가 한 번만 보내 큰 message에서는 link를 다 못 씀, NVLSTree는 NVLink SHARP offload |
| CollTree | 빠른 local domain마다 local tree를 만들고 group별 leader가 RDMA로 2단계 tree에 참여, 두 단계를 pipeline | Node 간 단계를 O(log N)으로 줄이면서 node 안에서는 full bandwidth, node 간 지연이 지배적인 작고 중간 크기 message에 유리 |
| CollNet | Local interconnect를 공유하는 GPU group 안에서 ring이나 local tree로 집계한 뒤 leader가 2단계 tree reduction | Internode 저지연과 intranode 고대역폭을 함께 얻어 매우 큰 multi-node cluster의 network 부하를 줄임 |
| PAT | Tensor를 segment로 나누고 segment마다 tree 기반 reduce-scatter를 엇갈려 연속으로 띄움 | Ring에 가까운 처리량과 segment당 O(log N)의 tree 수준 지연을 함께 얻는 절충안 |
PAT (parallel aggregated tree)는 한 segment의 tree reduction이 끝나기 무섭게 다음 segment가 round-robin으로 자기 tree reduction을 시작하는 방식이라, 늘 전송 중인 작업이 있어 link가 포화된 상태를 유지한다.
Algorithm 선택은 결국 message 크기와 topology로 정해지는데, 책은 수십 MB 수준의 작은 message는 단계가 적은 tree가, 큰 message는 대역폭을 잘 쓰는 ring이 유리하다고 정리한다.
NCCL은 NVLink로 연결된 system에서 작고 중간 크기 message의 all-reduce 지연을 줄이는 symmetric memory 최적화와 low-latency kernel도 지원해 최대 ~7.6배까지 줄어든 사례가 있고, NVLink domain 안에서 NVSwitch의 hardware multicast로 갱신된 model weight처럼 같은 data를 모든 GPU에 한 번에 보내는 one-hop broadcast도 할 수 있다.
InfiniBand의 SHARP와 NVSwitch fabric의 NVLS (NVLink SHARP)도 NCCL-SHARP plugin이 설정돼 있으면 all-gather와 reduce-scatter 같은 collective를 가속한다.
기본적으로 NCCL은 communicator 초기화 시점에 message 크기와 interconnect topology, GPU 세대를 보고 collective마다 가장 빠른 algorithm과 protocol 조합을 고른다.
Profiling에서 node 간 지연이 비정상적으로 높은 식의 비효율이 보이면 NCCL_ALGO=NVLSTree,PAT처럼 환경 변수로 해당 communicator의 algorithm을 강제할 수 있는데, code에서 설정한다면 ncclCommInitRank()를 호출하기 전에 해야 한다.
Distributed Data Parallel Strategies
수십억에서 수조 parameter model의 대규모 학습과 추론은 data parallel과 tensor parallel, pipeline parallel, expert parallel, context parallel을 조합해야 선형에 가깝게 확장되고, 핵심은 모든 수준에서 통신과 연산을 overlap하는 것이다.
All-reduce에는 NCCL을, one-to-one 전송에는 NIXL을 쓰고, 초대형 규모에서는 gradient accumulation과 activation checkpointing도 처리량을 잃지 않고 memory를 관리하는 데 중요하다.
한 node의 여러 GPU로 확장할 때 PyTorch는 data를 나누는 data parallel과 model을 나누는 model parallel을 framework 수준에서 제공하는데, 책은 system 성능 관점에서 가장 기본적인 두 data parallel 전략인 nn.DataParallel (DP) $_[$$_{44}$$_]$와 torch.distributed.DistributedDataParallel (DDP) $_[$$_{45}$$_]$를 비교한다.
Activation과 gradient, parameter를 GPU들에 sharding해 model 전체 복제본을 두지 않는 FSDP (fully sharded data parallel) $_[$$_{13}$$_]$는 tensor parallel이나 pipeline parallel과 함께 쓰이는 경우가 많은데, 책은 이를 Chapter 13에서 다룬다.
| 항목 | DP (nn.DataParallel) |
DDP (DistributedDataParallel) |
|---|---|---|
| Process 구조 | 단일 process가 GPU마다 thread를 두고 여러 GPU를 제어 | GPU마다 process 하나, 각자 model 복제본 보유 |
| GIL | Kernel launch가 GIL (global interpreter lock)에 막혀 Python에서 직렬화 | 별도 process라 영향 없음 |
| Gradient 집계 | GPU 0으로 모아 합산한 뒤 나머지 GPU로 broadcast, 동기식으로 backward를 막음 | NCCL all-reduce로 GPU끼리 직접 교환, backward와 overlap |
| 확장성 | 2~4 GPU를 넘으면 main thread가 병목 | 주로 통신 대역폭에만 제한 |
| 책의 예시 측정 | 45 ms | 30 ms |
DP는 입력 batch를 GPU 수만큼 나눠 (예시에서는 [512, 1024]를 [256, 1024] 두 개로) 각 GPU에서 forward를 실행하고, 첫 forward 호출 때 GPU 0의 model을 다른 GPU로 자동 복사한다.
GPU마다 thread를 하나씩 두어 enqueue하지만 GIL을 두고 경쟁해 kernel launch 호출은 Python에서 순서대로 일어나고, forward 뒤에는 모든 출력을 GPU 0으로 모아 loss를 계산하며 backward에서는 gradient를 GPU 0으로 모아 합산한 뒤 나머지 GPU로 다시 broadcast한다.
그래서 Python controller thread가 device마다 kernel launch를 직렬화하는 CPU 측 overhead와, 연산과 overlap되지 않는 gradient 집계 때문에 GPU 0이 병목이 되는 문제를 함께 안는다.
DDP는 torch.multiprocessing.spawn 등으로 GPU마다 process를 하나씩 띄우고, 공정한 비교를 위해 process당 batch 256으로 전체 512를 맞춘다.
실행은 torchrun $_[$$_{46}$$_]$이나 cluster의 MPI/SLURM/Kubernetes 통합으로 MASTER_ADDR, MASTER_PORT를 설정해서 하는데, 책은 자주 놓치는 환경 변수를 함께 적어둔다.
1 | # Environment (common gotchas) |
같은 양의 data를 처리하는데 DDP가 30 ms로 DP의 45 ms보다 33% 빠르다.
각 process가 GIL 경합 없이 batch 절반씩을 진짜 병렬로 처리하고, NCCL all-reduce가 backward와 overlap되며, gradient를 GPU 0으로 모았다가 되돌리는 추가 복사 없이 각 GPU의 gradient가 제자리에서 직접 교환·평균되고, 통신 부담도 GPU 하나에 몰리지 않고 all-reduce에 참여하는 모든 GPU로 분산되기 때문이다.
Model이 클수록, 특히 GPU 수천 장으로 확장할수록 차이는 더 벌어져 DP는 2~4 GPU를 넘으면 초선형으로 나빠질 수 있는 반면 DDP는 CPU나 단일 GPU overhead가 아니라 통신 대역폭에만 주로 제한된다.
PyTorch 팀도 명시적으로 권장하듯 multi-GPU 학습에는 항상 DDP를 쓰고, DP는 사용 편의가 성능보다 중요한 GPU 두 장짜리 빠른 prototype 정도에서만 용인된다.
NCCL Communicator Lifecycle and Environment Gotchas
NCCL이 저수준 세부 사항 대부분을 감추더라도 code에서 NCCL을 어떻게 쓰는지가 여전히 성능에 영향을 주고, NCCL의 많은 환경 변수는 잘못 설정하면 성능을 떨어뜨리거나 hang을 일으킨다.
Pitfall #1: Creating NCCL communicators too often
NCCL communicator는 collective로 통신할 수 있는 GPU (rank)의 group인데, C++의 ncclCommInitRank나 PyTorch의 torch.distributed.init_process_group으로 만드는 비용이 크다.
모든 rank가 고유 ID와 network 주소를 교환하고 ring과 tree를 구성하며 buffer까지 할당해야 해서, GPU 32장에서 rank마다 communicator를 따로 만들면 2~3초면 될 일이 2~3분으로 늘어나고, all-to-all handshake 때문에 rank 수에 대해 선형보다 나쁘게 늘어나기도 한다.
DDP에서는 program 시작 시 init_process_group을 한 번 호출하면 DDP가 모든 process용 communicator 하나를 만들어 매 iteration의 모든 collective에 재사용한다.
책은 iteration마다 process group을 만들고 없애는 잘못된 예제와, loop 밖에서 한 번만 초기화하는 예제를 비교한다.
| 지표 | Before (iteration당) | After (iteration당) |
|---|---|---|
init_process_group + destroy |
48.0 ms | 0 ms |
dist.all_reduce (원소 1개) |
0.5 ms | 0.5 ms |
| 전체 iteration 시간 | 48.5 ms | 0.5 ms |
All-reduce 자체는 0.5 ms로 같지만 이전에는 초기화 비용이 iteration을 지배해, 한 번만 초기화하면 iteration 시간이 98% 넘게 줄고 rank가 많은 실제 multi-node 환경에서는 절감이 더 커진다.
Pitfall #2: Do not create and destroy NCCL communicators on every iteration
Model parallel이나 pipeline parallel용 부분 group을 정의하면서 실수로 communicator를 새로 만들지 않도록, torch.distributed.new_group()으로 처음에 한 번만 부분 communicator를 만들어 재사용한다.
Runtime에 membership이 동적으로 바뀌거나 단계적으로 초기화해야 해서 communicator를 여러 개 만들어야 한다면, NCCL C++ API의 ncclGroupStart(), ncclCommInitRank(...), ncclGroupEnd()로 한꺼번에 초기화해 overhead를 크게 줄인다.
집필 시점 기준 PyTorch는 communicator를 완전히 해체하지 않고는 runtime의 동적 membership 변경을 지원하지 않고, hang을 막으려면 모든 rank가 생성과 해체를 같은 순서로 호출해야 한다.
Pitfall #3: Avoid overtuning or disabling NCCL features with environment variables
NCCL 환경 변수는 특별한 이유가 없으면 기본값으로 두되, 기본값에 기대기보다 현재 기본값을 명시적으로 설정하고 release note를 보며 조정하는 편이 낫다고 저자는 권한다.
흔한 실수는 debugging 중 기능을 끄고 production에서 다시 켜는 것을 잊는 것으로, P2P (peer-to-peer)를 끈 NCCL_P2P_DISABLE=1이 남아 있으면 node 안 traffic이 NVLink 대신 CPU host의 중간 buffer를 거쳐 지연이 수 µs에서 수십 µs로 늘고 대역폭이 수백 GB/s에서 수십 GB/s로 떨어지며, NCCL_SHM_DISABLE=1이 남아 있으면 node 안 통신에 shared memory를 못 써 network나 host를 거치는 복사로 넘어간다.
| 환경 변수 | 역할 | 권장 |
|---|---|---|
NCCL_BUFFSIZE |
통신 buffer 크기, 키우면 큰 all-reduce의 대역폭 개선 | 4 MB에서 시작해 단계적으로 올리며 GPU memory 압박을 확인 |
NCCL_DEBUG |
Log 수준 (VERSION, WARN, INFO, DEBUG) |
기본은 WARN, 문제 추적 시 INFO, production에서 DEBUG는 피함 |
NCCL_NSOCKS_PERTHREAD · NCCL_SOCKET_NTHREADS |
Thread당 socket 수와 socket thread 수 | NIC가 여럿이거나 대역폭이 매우 크면 증가, 두 값의 곱은 64 이하 |
NCCL_MIN_NCHANNELS · NCCL_MAX_NCHANNELS |
여러 NVLink를 병렬로 쓰기 위한 channel (subring) 수, channel 하나가 CUDA block 하나 | 기본값 유지, NVSwitch system에서는 NCCL이 topology와 message 크기로 자동 조정 |
NCCL_TOPO_FILE · NCCL_TOPO_DUMP_FILE |
Topology 파일 지정 · NCCL이 감지한 topology를 파일로 저장 | Cloud처럼 topology 감지가 틀리기 쉬운 환경에서 활용 |
NCCL_MNNVL_ENABLE |
MNNVL (multi-node NVLink) 활성화 | NVL72 GB200/GB300처럼 multi-node NVLink switch를 지원하는 system |
NCCL_SHARP_DISABLE |
SHARP in-network aggregation 사용 여부 | A/B test나 문제 추적 때만 1 |
64라는 상한은 communicator당 허용되는 TCP socket 연결 수의 NCCL 내장 최댓값으로, CPU와 network 자원 사용을 제한하고 OS와 hardware 한계를 넘지 않게 하려는 것이다.
결국 특정 값이 도움이 된다는 근거가 있을 때만 바꾸고, 바꿨다면 문서로 남겨 hardware나 NCCL version을 올릴 때마다 효과가 여전한지 계속 확인해야 한다.
Pitfall #4: Verify CPU-GPU NUMA-node affinity for NCCL threads
NCCL은 network polling과 kernel dispatch를 위한 background CPU thread를 띄우는데, torch.multiprocessing이나 MPI (message passing interface)로 띄운 process는 전체 core 또는 taskset, numactl로 묶은 일부 core를 대상으로 하는 CPU affinity mask를 물려받는다.
NCCL은 보통 자기가 담당하는 GPU에 가까운 core에 thread를 두지만, process가 좁은 core 집합에 pin돼 있으면 NCCL thread가 core 하나로 몰려 scheduling이 나빠지고 처리량이 떨어진다.
권장 방식은 각 GPU process를 자기 NUMA domain의 CPU core에 묶은 뒤 NCCL_IGNORE_CPU_AFFINITY=1로 물려받은 mask를 무시하게 해, NCCL이 그 NUMA domain 안에서 worker thread를 자유롭게 퍼뜨리게 하는 것이다.
NUMA node 두 개에 GPU 여덟 장이 붙은 node라면 GPU 0~3의 rank는 첫 CPU의 core에, 4~7은 두 번째 CPU의 core에 묶고 이 변수를 켜는 식인데, numactl이나 CUDA_DEVICE_ORDER, CUDA_VISIBLE_DEVICES로 binding을 강제할 수 있고, 직접 pin하기 싫다면 MPI runtime binding이나 SLURM의 --cpu-bind로 rank가 올바른 core에 가게 할 수 있다.
Pitfall #5: Resist the temptation to ignore NCCL warnings and errors
NCCL log에 “unable to enable P2P, falling back to copy”가 보인다면 두 GPU가 서로 다른 PCIe root complex에 있는 식의 이유로 직접 P2P를 못 열어 data가 host CPU memory buffer를 거친다는 뜻이므로, 서로 통신하는 GPU를 같은 NUMA node에 두거나 짝을 다시 짜야 한다.
“NCCL INFO NET/Socket: using Ethernet interface eth0”처럼 선택된 interface가 가장 빠른 interconnect가 아니라면 NCCL_SOCKET_IFNAME=ib0로 bootstrap handshake가 의도한 fabric을 쓰게 하되, 왜 자동으로 가장 빠른 interface가 잡히지 않는지도 더 큰 문제의 징후로 보고 추적해야 한다.
Pitfall #6: NCCL communicator hangs, errors, or shuts down completely
Process 하나가 죽거나 rank 하나가 오류를 내면 collective가 끝나지 않아 나머지 rank가 hang될 수 있는데, 대규모 cluster에서는 GPU 고장이 잦아 드문 일이 아니다.
Meta가 Llama 3 405B를 54일간 pretraining하며 겪은 예기치 않은 중단 원인을 보면 $_[$$_{47}$$_]$, 절반 가까이가 GPU와 HBM3 고장이다.
| 구성 요소 | 분류 | 중단 횟수 | 비율 |
|---|---|---|---|
| Faulty GPU | GPU | 148 | 30.1% |
| GPU HBM3 memory | GPU | 72 | 17.2% |
| Software bug | Dependency | 54 | 12.9% |
| Network switch/cable | Network | 35 | 8.4% |
| Host maintenance | Unplanned Maintenance | 32 | 7.6% |
| GPU SRAM memory | GPU | 19 | 4.5% |
| GPU system processor | GPU | 17 | 4.1% |
| NIC | Host | 7 | 1.7% |
| NCCL watchdog timeouts | Unknown | 7 | 1.7% |
| Silent data corruption | GPU | 6 | 1.4% |
| GPU thermal interface and sensor | GPU | 6 | 1.4% |
| SSD | Host | 3 | 0.7% |
| Power supply | Host | 3 | 0.7% |
| Server chassis | Host | 2 | 0.5% |
| IO expansion board | Host | 2 | 0.5% |
| Dependency | Dependency | 2 | 0.5% |
| CPU | Host | 2 | 0.5% |
| System memory | Host | 2 | 0.5% |
NCCL_ASYNC_ERROR_HANDLING=1은 오류가 나면 NCCL이 비동기로 abort하게 해 약간의 overhead를 대가로 복원력을 높이고, 최신 PyTorch는 init_process_group에서 이를 기본으로 켜지만 저자는 기본값이 version마다 바뀔 수 있고 바뀌면 추적하기 매우 어려우므로 항상 명시적으로 설정하라고 강조한다.
NCCL을 upgrade할 때는 release note를 보고, 기본값과 성능이 달라질 수 있으니 반드시 다시 test해야 한다.
Profiling and Debugging NCCL
NCCL은 network 오류 같은 상황에 대비한 비동기 오류 처리와 failover를 지원해 NCCL_ASYNC_ERROR_HANDLING=1로 켜고, debugging할 때는 NCCL_DEBUG=WARN이나 INFO를 함께 켜서 rank 불일치나 socket 설정 오류 같은 흔한 문제를 확인한다.
GPU cluster가 커질수록 진단하기 어려워지는 성능 문제를 위해 NCCL은 profiler plugin API $_[$$_{48}$$_]$도 제공하는데, GPU 통신의 내부 timeline을 보면서 뒤처지는 device나 병목을 짚을 수 있다.
Plugin은 NCCL_PROFILER_PLUGIN 환경 변수로 다른 NCCL plugin처럼 동적으로 load되고, PyTorch Kineto $_[$$_{49}$$_]$ 같은 third-party profiler가 NCCL과 쉽게 통합되도록 만든 것이라 plugin이 없어도 Kineto는 CUPTI와 NVTX로 NCCL 활동을 모을 수 있다.
Load되면 group, collective, point-to-point, proxy 관련 연산처럼 NCCL event마다 bit 하나를 대응시킨 32-bit event activation mask를 설정해 event를 계층적으로 표현한다.
| Callback | 역할 |
|---|---|
init |
불투명한 context를 제공하며 plugin을 설정하고 profiling할 event를 정함 |
startEvent |
NCCL에서 event descriptor를 받아 새 event 객체를 할당하고 handle을 돌려줌 |
stopEvent |
Event 완료를 표시해 자원을 재활용하게 함 |
recordEventState |
Event가 여러 상태를 거칠 때 plugin이 event를 갱신 |
finalize |
Profiling이 끝나면 profiler context의 모든 자원을 해제 |
In-Network SHARP Aggregation
SHARP는 Quantum 계열 InfiniBand switch에서 NCCL-SHARP plugin으로 쓰는 in-network reduction 기술이고, NVLink domain에서 같은 역할을 하는 것이 NVSwitch fabric 안에서 collective를 offload하는 NVLS로, NVL72 같은 NVLink Switch domain에서 collective와 domain 전체의 all-to-all, broadcast를 가속한다.
실제로는 여러 GPU의 data가 switch로 흘러들어올 때 switch가 합산 같은 reduction을 수행해 부분 결과를 나눠주므로, 각 GPU가 중간 결과를 다른 GPU들과 중복해서 주고받지 않아도 되고 큰 MPI와 NCCL collective의 지연이 줄어든다.
Data 양으로 보면 ring reduce-scatter에서 각 GPU는 $n-1$ hop에 걸쳐 $\frac{B(n-1)}{n}$ bytes를 받는데, in-network reduction에서는 switch가 합산해 $\frac{B}{n}$만 돌려줘 endpoint당 수신량이 full ring의 $\frac{1}{n-1}$이 된다.
All-gather에서는 NVLS의 hardware multicast로 각 GPU가 자기 $\frac{B}{n}$ 조각을 한 번만 보내면 network가 복제해줘 송신량이 역시 $\frac{1}{n-1}$로 줄고, multicast all-gather와 in-network reduce-scatter를 overlap하면 shard 교환의 실제 시간이 두 연산의 합이 아니라 큰 쪽이 되어 대역폭이 병목인 단계의 시간이 ~절반까지 줄어든다.
다만 all-gather에는 산술 reduction이 없어서 NVLS는 주로 multicast 복제로 도움을 주고, 속도 향상은 all-reduce나 reduce-scatter보다 작다.
InfiniBand fabric에서 NCCL이 all-reduce 같은 collective를 SHARP로 offload하려면 switch에 SHARP firmware가, Subnet Manager와 함께 관리 서버에 SHARP Aggregation Manager가 떠 있어야 하고, 각 host에 GPUDirect RDMA kernel module이 올라와 있어야 하며, NCCL RDMA SHARP plugin이 선택돼야 한다.
NVIDIA는 대규모 AI system의 all-reduce에서 2~5배 속도 향상을 보고하는데, network가 병목이 되는 대규모에서 효과가 두드러져 compute node 두세 대에서는 체감이 적지만 32대라면 통신 단계 수를 줄여 collective 지연을 크게 낮춘다.
SHARP는 기본으로 켜지지 않아 plugin 선택이나 정책으로 설정해야 하고, NCCL_SHARP_DISABLE=1로 꺼서 A/B test로 효과를 확인할 수 있다.
Code 변경은 대체로 필요 없고, NCCL_DEBUG=INFO log에 SHARP가 언급되는지로 사용 여부를 확인하며 ibv_devinfo 같은 도구로 device의 SHARP 지원을 확인한다.
집필 시점 기준 SHARP는 주로 InfiniBand 기술이라, NVIDIA Spectrum-X Ethernet platform은 congestion control과 adaptive routing으로 all-reduce 성능을 높이지만 SHARP 같은 switch 내장 reduction engine은 노출하지 않는다.
Switch의 reduction buffer에는 한계가 있어 수 MB에서 GB 단위의 아주 큰 collective는 hardware 한계를 넘으면 일반 방식으로 fallback할 수 있으므로, NCCL log를 계속 보다가 memory 압박으로 SHARP가 아닌 집계로 떨어지기 시작하면 alert가 오도록 해두는 것이 좋다.
Persistent NCCL User Buffers and Zero-Copy Registration
NCCL은 user buffer registration $_[$$_{50}$$_]$을 지원해 collective가 내부 staging 없이 사용자의 tensor buffer에서 직접 동작하게 하므로 복사와 내부 channel 압박이 줄고, zero-copy 등록으로 collective를 가속하면서 SM과 channel 사용량도 줄일 수 있어 node 안 (NVLS)과 node 밖 (InfiniBand) 모두에서 SHARP의 최적 경로를 쓰려면 사실상 필수다.
등록과 해제는 ncclCommRegister()와 ncclCommDeregister()로 하는데, communicator 안의 rank 하나라도 등록된 buffer를 쓰면 모든 rank가 써야 하고, 일부 algorithm에서는 buffer 시작점으로부터의 offset도 rank 사이에 일치해야 한다.
NVIDIA’s NIXL and Disaggregated Inference
NCCL은 학습에서 흔한 many-to-many group 통신에 강하지만, 대규모 AI 추론은 이와 다른 통신 요구를 만들어냈다.
NVIDIA’s NIXL is an open source, high-throughput, low-latency, point-to-point communication library released in early 2025.
NIXL was designed specifically to accelerate large-scale LLM distributed and disaggregated inference.
NIXL $_[$$_{8}$$_]$은 NVIDIA의 open source 추론 engine인 Dynamo $_[$$_{51}$$_,$$_{52}$$_]$의 핵심 구성 요소로, disaggregated 단계들이 공유하는 KV (key-value) cache를 옮기는 것처럼 one-to-one, one-to-few 전송을 최소 지연과 overhead로 처리해 many-to-many collective 중심의 NCCL을 보완한다.
GPU와 CPU, SSD, 공유 network storage 사이의 data 이동에 일관된 비동기 API를 제공하면서 옮기는 cache chunk마다 가장 빠른 경로를 고르는데, Dynamo의 KV Cache Manager는 이 NIXL로 자주 쓰이지 않는 KV cache를 더 경제적인 memory 계층으로 내린다.
긴 context window를 서빙할 때 NIXL을 쓰면 추론 engine이 100 GB 같은 큰 KV cache를 NVLink나 InfiniBand로 다른 peer에 최소 overhead로 넘기고 GPU를 새 요청 처리에 쓸 수 있다.
NIXL은 GPUDirect RDMA로 node 사이 GPU memory 간에 data를 직접 옮겨 host memory를 완전히 우회하고, RDMA 지원 NIC (또는 DPU)가 GPU memory 사이의 전송을 직접 수행해 CPU가 data 경로에 끼지 않으므로 지연이 낮다.
NCCL은 여전히 all-reduce처럼 대규모 학습에 흔한 many-to-many collective의 표준이고, NIXL은 KV cache 이동처럼 대규모 추론에 흔한 one-to-one, one-to-few 전송을 겨냥해 NCCL을 대체하지 않고 보완한다.
Separate Prefill and Decode Inference Stages
Transformer 기반 model의 추론은 두 단계로 나뉘는데, 들어온 요청 data (prompt)로 행렬 곱을 많이 수행해 KV cache를 만드는 prefill은 대개 compute bound이고, GPU HBM에서 model weight를 읽어 다음 token (completion 또는 response)을 계산하는 decode는 대개 memory throughput bound다.
이 prefill/decode 분리는 vLLM $_[$$_{53}$$_]$과 SGLang $_[$$_{54}$$_]$, NVIDIA Dynamo, TensorRT-LLM $_[$$_{55}$$_]$ 같은 추론 engine에 구현돼 있고, NIXL은 이 흐름에서 node 사이의 KV cache 전송을 가속한다.
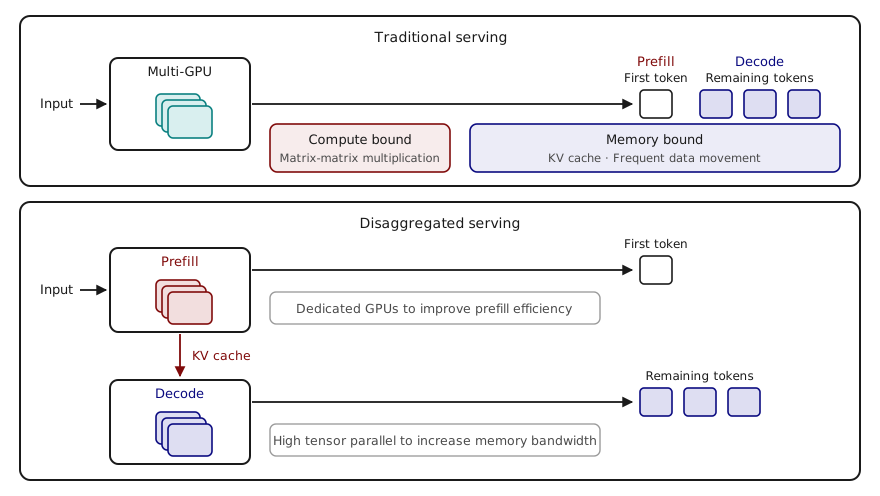
위쪽 전통적인 구성에서는 GPU node 하나가 compute bound인 prefill과 memory·I/O bound인 decode를 모두 맡고, 아래쪽 disaggregated serving에서는 prefill worker와 decode worker를 서로 다른 GPU cluster에 둔다.
Prefill cluster의 GPU가 입력 sequence의 KV cache를 만들어 NIXL로 decode cluster의 GPU에 넘기는데, 이렇게 단계별로 특화하면 전체 처리량이 오르고 확장 구성도 유연해진다.
긴 prompt라면 KV cache가 수십 GB에 이를 수 있어 사용자가 눈치채지 못하는 속도로 text를 생성하려면 거의 실시간으로 한 처리 장치에서 다른 장치로 옮겨져야 하는데, CPU memory나 storage를 거치는 전통적인 방법으로는 이 속도와 지연을 맞추지 못한다.
필요한 것은 구성 요소 사이의 고대역폭 GPU 간 직접 전송이고 이 통신이 연산과 overlap되어, 목적지 GPU가 다음 입력 token들의 KV cache를 받는 중에도 다음 token 계산을 시작할 수 있어야 한다.
NIXL은 GPU 하나에서 다른 GPU나 작은 GPU group으로, compute node와 rack을 넘어서까지 data를 옮기는 직접 채널을 제공하면서 가용 경로 중 가장 빨리 도착하는 것을 고르는데, NCCL의 경로 선택과 비슷하지만 one-to-one의 큰 message 같은 추론 pattern에 맞춰져 있다.
같은 board라면 NVLink나 NVLink-C2C를, rack domain 안이라면 NVSwitch를, rack 사이라면 InfiniBand나 RoCE를, 필요하면 NVMe storage 직접 접근까지 쓰는 식으로, GB200/GB300 NVL72 rack 안에서는 NVSwitch network를 먼저 쓰고 rack을 넘으면 지원 여부에 따라 InfiniBand나 Ethernet RDMA로 자동 전환한다.
Intelligent Interconnect Routing for KV Cache Transfers
전통적으로는 GPU 간 data를 CPU를 거쳐 옮길 수 있지만 너무 느리고, 원본과 목적지 GPU를 같은 compute node에 두도록 강제하면 확장 유연성이 줄어드는데, NIXL은 KV cache 같은 큰 payload를 GPU와 compute node, 필요하면 rack을 넘어 직접 옮기도록 설계됐다.
높은 대역폭으로 동작하면서 통신을 연산과 최대한 overlap해 목적지 GPU가 원본 GPU에서 KV cache를 받는 동안 다음 token을 생성하기 시작하게 하고, interconnect에 의존하지 않아 같은 compute node라면 NVLink를, 같은 rack domain이라면 NVSwitch를, node 사이라면 InfiniBand나 RDMA Ethernet을, 필요하면 PCIe나 NVMe까지 쓰면서 NCCL처럼 항상 가장 빠른 interconnect로 경로를 잡는다.
GPU HBM과 CPU DRAM, NVMe SSD처럼 서로 다른 memory 계층 사이의 전송도 같은 방식으로 지원한다.
NIXL Asynchronous API with Callbacks
개발자 입장에서 NIXL API는 단순해서, data pointer와 목적지 (GPU, CPU, Amazon S3 같은 storage target)를 담은 전송 요청을 올리면 NIXL이 가능한 한 빨리 옮기고, 같은 API로 KV cache 조각을 다른 GPU나 CPU host memory buffer, object storage service로 보낼 수 있다.
Module식 설계라 사용자 API를 바꾸지 않고 새 protocol이나 더 빠른 storage-class memory 같은 transport도 받아들일 수 있고, 내부에서는 GPU 간 NVLink 전송이나 GDS를 통한 GPU와 NVMe SSD 사이 전송, NVSwitch fabric 중 가장 빠른 것을 골라 KV cache 조각을 offload할 때 거의 line rate에 가까운 성능을 낸다.
흐름은 registerMem으로 memory를 등록하고, trim으로 전송 descriptor를 얻고, prepXfer로 nonblocking 요청을 준비해 postXfer로 제출한 뒤, 돌려받은 request handle을 checkXfer로 polling해 완료를 확인하는 순서이고, 직접 PCIe나 NVLink 복사, RDMA 전송, GPUDirect Storage 같은 storage 경로 중 무엇을 쓸지는 NIXL이 정한다.
Nonblocking이라 CPU overhead가 적고, downstream kernel이 전송 자체를 기다리지 않고 도착한 data부터 소비할 수 있어 목적지 GPU는 나머지 chunk가 아직 전송 중이어도 먼저 도착한 KV cache chunk로 일을 시작할 수 있다.
nixlAgent는 endpoint 설정과 memory 등록, backend 선택을 담고 metadata와 연결 정보, 다른 agent와의 비동기 전송 요청을 관리하는 NIXL의 핵심 전송 객체로, instance 하나가 전송의 endpoint 하나를 나타내므로 전송 하나에 원본 쪽 agentSrc와 목적지 쪽 agentDst 두 개가 필요하고 NIXL은 둘 사이의 최적 경로를 협상한다.
책의 예제에서 두 agent를 만들고 GPU buffer를 등록한 뒤 VRAM에서 VRAM으로 nonblocking 전송을 하는 핵심 부분은 다음과 같다.
1 | // 5) Register memory with each agent and trim to xfer descriptors |
Agent는 cfg.backends = {"UCX"}처럼 backend를 지정해 만들고, 전송이 진행되는 동안 program은 다른 일을 하다가 checkXfer가 진행 중이면 thread를 양보하며 기다리고, 성공하면 releaseReqH로 handle을 풀고 deregisterMem으로 등록을 해제한다.
내부적으로 NIXL은 InfiniBand와 TCP, shared memory 같은 여러 interconnect 위에 통합 API를 제공하는 HPC library인 UCX를 저수준 transport로 쓰고, GPUDirect RDMA와 IBGDA로 CPU 개입 없이 GPU가 전송을 시작하게 해서 data 경로가 순수하게 RDMA여도 전송 시작은 CPU가 해야 했던 예전 system보다 지연을 더 줄인다.
Staging buffer 같은 불필요한 복사도 피해서, data가 pageable CPU memory에 있으면 page out되지 않도록 pin하고 GPU memory에 있으면 중간 host buffer를 거치지 않고 바로 보낸다.
KV Cache Offloading with NIXL
NIXL의 설계 동기는 LLM 추론의 큰 memory를 다루는 best practice와 맞닿아 있어서, 긴 sequence나 multi-turn 대화의 KV cache 전체를 GPU memory에 담지 못하면 NIXL로 추론 서버 (예를 들어 NVIDIA Dynamo)가 KV cache를 CPU memory나 NVMe SSD로 내렸다가 필요할 때 다시 가져온다.
빠른 NVLink로 CPU와 GPU memory를 크게 공유하는 Grace Hopper와 Grace Blackwell Superchip이라면 Dynamo의 KV Cache Manager와 함께 이 계층을 효율적으로 관리해, 큰 KV cache를 넉넉한 CPU memory로 빠르게 내려 한정된 GPU HBM을 비울 수 있다.
책이 인용한 NVIDIA의 측정 $_[$$_{56}$$_]$에서 PCIe 기반 x86 + H100 system은 긴 입력 sequence에서 cache를 다시 계산하는 것보다 offload한 cache를 쓰는 편이 TTFT (time to first token)를 최대 14배 개선했고, 900 GB/s NVLink-C2C를 쓰는 ARM 기반 Grace Hopper Superchip은 이 x86 H100 구성보다 TTFT가 다시 2배 빨랐다.
NIXL은 이런 수치를 염두에 두고 설계돼 전송 비용을 낮게 유지하는 덕분에 KV cache offloading을 현실적인 선택지로 만들고, memory 용량이 제약인 초대형 LLM에서 특히 대규모 추론 배포의 핵심이 된다.
Pipeline parallelism의 단계 사이나 GPU와 storage 같은 구성 요소 사이로 큰 data를 옮겨야 한다면 NCCL로 충분한지, NIXL 같은 전용 solution이 나은지를 따져봐야 한다.
NIXL and High-Performance Inference Systems Like NVIDIA Dynamo
NIXL이 성능에 주는 영향은 역시 2025년 초에 나온 NVIDIA Dynamo 같은 분산 추론 system에서 크게 나타나는데, NVIDIA 내부 test $_[$$_{57}$$_]$에서 open source Dynamo framework는 NIXL을 써서 72-GPU Blackwell NVL72 rack의 ~680B parameter LLM에서 최대 30배 높은 추론 처리량을 냈다.
Node 사이로 수 GB의 context data를 옮기는 것이 한때 큰 지연 장벽이었는데 NIXL에서는 비교적 빠른 비동기 연산이 됐고, Dynamo와 TensorRT, vLLM의 추론 최적화는 뒤 장에서 자세히 다룬다.
NCCL Versus NIXL
NIXL은 NCCL을 대체하는 것이 아니라 보완하는 것으로, NCCL은 여러 GPU가 all-reduce처럼 한 작업이나 단계를 병렬로 처리할 때의 동기식 collective를 맡고 NIXL은 작업이나 단계 사이, 또는 분산 system의 서로 다른 구성 요소 (GPU, CPU, storage) 사이의 비동기 data 전송을 맡는다.
| 항목 | NCCL (collective communication) | NIXL (point-to-point communication) |
|---|---|---|
| 주 용도 | 학습에서 긴밀히 묶인 GPU group의 many-to-many collective (all-reduce, all-gather) | 분산 추론이나 pipelining의 one-to-one, one-to-few 전송 (큰 tensor나 cache) |
| 통신 pattern | 동기식 collective, 모든 참여자가 호출에 도달해야 함 (barrier 의미) | 비동기 send/receive, 시작자 하나에 대상 하나 이상 (단방향 이동 지원) |
| 연산과 overlap | 별도 CUDA stream으로 어느 정도 가능 (DDP에서 backward와 all-reduce를 overlap) | 최대 overlap을 전제로 설계, 전송이 연산과 완전히 병렬로 실행되고 polling으로 완료 감지 |
| Topology 인식 | Topology를 자동 감지해 ring과 tree, NVLink/NVSwitch를 collective에 최적으로 활용 | Interconnect에 비의존, 원본과 목적지 위치에 따라 NVLink·NVSwitch·PCIe·InfiniBand/RDMA·GDS 자동 선택 |
| Data 범위 | 모든 GPU에 걸쳐 집계해야 하는 작거나 중간 크기 tensor (gradient) | 빠른 point-to-point 이동이 필요한 수백 MB 이상의 큰 blob (LLM KV cache, model shard) |
| 통합 | 학습 framework에 내장 (PyTorch DDP, Horovod 등이 내부에서 호출) | NVIDIA Dynamo 프로젝트에서 개발하는 open source library, 추론 서버나 custom code에서 API 직접 호출 |
| 예시 | GPU 8장에 걸친 100 MB gradient all-reduce | 추론 pipeline에서 1 GB KV cache를 GPU 0에서 GPU 1 (또는 CPU memory, NVMe SSD)로 전송 |
NCCL도 peer-to-peer send()/recv()를 지원하지만 동기식 학습 환경의 collective에 가장 잘 맞고, NIXL은 대규모 추론과 pipeline parallelism에 흔한 비동기 point-to-point 전송의 요구를 다룬다.
정리하면 NCCL은 PCIe와 NVLink, InfiniBand, Ethernet link를 포화시키는 topology 인식 ring·tree algorithm을 자동으로 골라 단일 host와 node 사이 모두에서 collective 처리량을 극대화하는 초대형 학습용이고, NIXL은 그 고성능 원칙 위에서 GPU와 CPU, storage device 사이의 비동기·hardware 비의존 point-to-point 전송을 조율하는 대규모 분산 추론용이다.
Key Takeaways
책이 장 끝에 정리한 세 가지로, 저자는 이 장의 기법들로 hardware의 물리적 “speed of light” 한계에 가깝게 갈 수 있다고 본다.
- Topology matters: Node 사이 (InfiniBand)와 node 안 (NVLink/NVSwitch)의 interconnect가 최적의 통신 전략을 좌우하므로 multi-node, multi-GPU 구성에서는 계층적 방식을 고려한다. 설정 실수나 예상치 못한 기본값 때문에 느린 경로로 data를 보내고 있지 않은지 확인하고, NCCL의 동작을 점검하면서 가능하다면 SHARP 같은 in-network 집계를 쓴다.
- Tune the environment and system: 환경 변수나 OS 설정 하나가 처리량을 끌어올리기도 한다. NIC buffer를 늘리고, NCCL 기능과 logging을 켜고 끄고, CPU를 올바르게 pin하며, 2편에서 본 IRQ affinity 같은 OS와 driver 수준 최적화로 병목을 없앤다.
- Utilize the latest hardware innovations: Grace Hopper와 Grace Blackwell Superchip의 큰 CPU memory와 빠른 CPU-GPU interconnect를 큰 dataset 보관이나 data 분할, model 분할, 큰 KV cache의 CPU offload에 쓴다. SHARP 같은 in-network computing은 특히 대규모에서 collective를 2~5배 가속하고, 새 세대가 나올 때마다 최적 구성이 바뀌므로 compute와 networking hardware의 변화를 계속 따라가야 한다.
목표는 GPU가 100% 연산하는 동시에 background에서 통신하고, network link는 쓸모 있는 data로 포화되며, disk는 전속력으로 data를 흘려보내는 상태를 함께 만드는 것이다.
그러려면 반복적인 조정과 검증, 그리고 memory 사용량과 code 복잡도가 느는 trade-off를 감수해야 하지만, 학습과 추론이 빨라지고 비싼 infrastructure의 활용도가 오르는 것으로 돌아온다.
Conclusion
고성능 분산 multi-GPU 통신과 storage system은 크고 복잡한 AI system을 조정하는 토대이고, collective에는 NCCL을, 추론 data 전송에는 NIXL을, 초저지연 통신에는 RDMA를 쓰면 병목을 크게 줄일 수 있다는 것이 이 장의 결론이다.
NVSwitch와 SHARP를 지원하는 InfiniBand switch 같은 똑똑한 networking hardware가 학습과 추론 성능으로 바로 이어지고, 최신 CUDA와 PyTorch에 이런 최적화가 들어가므로 software를 최신으로 유지하는 것도 중요하며, 추론이라면 NVIDIA Dynamo나 vLLM 같은 serving framework로 쉽게 배포할 수 있다.
결국 어느 한 구성 요소만으로는 최고 성능이 나오지 않고 고속 통신과 효율적인 data 처리, system 전체 조정을 함께 설계해야 확장성 있고 견고한 AI system이 된다.
성능 engineer에게 남는 교훈은 빠른 data 이동이 순수 연산 능력만큼 중요하다는 것으로, 세계에서 가장 빠른 GPU라도 CPU나 다른 GPU에서 오는 data를 계속 기다린다면 이득이 거의 없다.
Conclusion
NCCL과 RDMA는 이전 글에서 개념 위주로 정리했었는데, 이 장은 Gloo fallback이나 NCCL 환경 변수처럼 설정 하나로 처리량이 수십 배 갈리는 지점들을 수치와 함께 짚어준다.
다음 글에서는 Chapter 5 (GPU-Based Storage I/O Optimizations)를 다룬다.
GDS와 data loading pipeline처럼 storage에서 GPU까지 data를 끊김 없이 흘려보내는 방법들이 나온다.
References
- GitHub: cfregly/ai-performance-engineering
- GitHub: NVIDIA/MagnumIO
- NVIDIA: Magnum IO
- GitHub: NVIDIA/nccl
- NVIDIA: NCCL User Guide
- NVIDIA: GPUDirect RDMA
- NVIDIA: GPUDirect Storage Documentation
- GitHub: ai-dynamo/nixl
- NVIDIA: GB200 NVL72
- GitHub: pytorch/pytorch
- NVIDIA: NCCL Collective Operations
- PyTorch: Distributed Data Parallel
- PyTorch: FullyShardedDataParallel
- GitHub: deepseek-ai/DeepEP
- NVIDIA: How to Overlap Data Transfers in CUDA C/C++
- PyTorch: torch.profiler
- NVIDIA: Nsight Systems Documentation
- PyTorch: CUDA Semantics
- NVIDIA: CUDA Runtime API - Stream Synchronization Behavior
- GitHub: pytorch/pytorch#80595 - Overlapping Optimizer.step() with DDP backward
- NVIDIA: DOCA SNAP Services
- GitHub: NVIDIA/nvshmem
- NVIDIA: NVSHMEM Documentation
- GitHub: openucx/ucx
- OpenUCX: Unified Communication X
- NVIDIA: HPC-X
- NVIDIA: Scalable Hierarchical Aggregation and Reduction Protocol (SHARP)
- NVIDIA: BlueField Data Processing Units (DPU)
- NVIDIA: NetQ Documentation
- NVIDIA: Unified Fabric Manager (UFM)
- GitHub: Mellanox/nccl-rdma-sharp-plugins
- NVIDIA: Quantum-X800 InfiniBand Platform
- NVIDIA: Spectrum-X Ethernet Platform
- GitHub: linux-rdma/perftest
- NVIDIA: MLNX_OFED Documentation
- GitHub: google/bbr
- AWS: Elastic Fabric Adapter
- NVIDIA: Improving Network Performance of HPC Systems Using NVIDIA Magnum IO NVSHMEM and GPUDirect Async
- GitHub: pytorch/gloo
- PyTorch: Distributed Communication Package
- GitHub: NVIDIA/DCGM
- NVIDIA: Data Center GPU Manager (DCGM) User Guide
- NVIDIA: NCCL Environment Variables
- PyTorch: DataParallel
- PyTorch: DistributedDataParallel
- PyTorch: torchrun (Elastic Launch)
- arXiv 2024: The Llama 3 Herd of Models
- GitHub: NVIDIA/nccl - plugins/profiler
- GitHub: pytorch/kineto
- NVIDIA: NCCL User Buffer Registration
- GitHub: ai-dynamo/dynamo
- NVIDIA: Dynamo Documentation
- GitHub: vllm-project/vllm
- GitHub: sgl-project/sglang
- GitHub: NVIDIA/TensorRT-LLM
- NVIDIA: NVIDIA GH200 Superchip Accelerates Inference by 2x in Multiturn Interactions with Llama Models
- NVIDIA: Introducing NVIDIA Dynamo, A Low-Latency Distributed Inference Framework for Scaling Reasoning AI Models